Chaque correction a un score de confiance ; on n'applique que ce qui passe le seuil. Pas de correction hasardeuse.
Extension · NLP · 09/11
AutoCorrect Pro
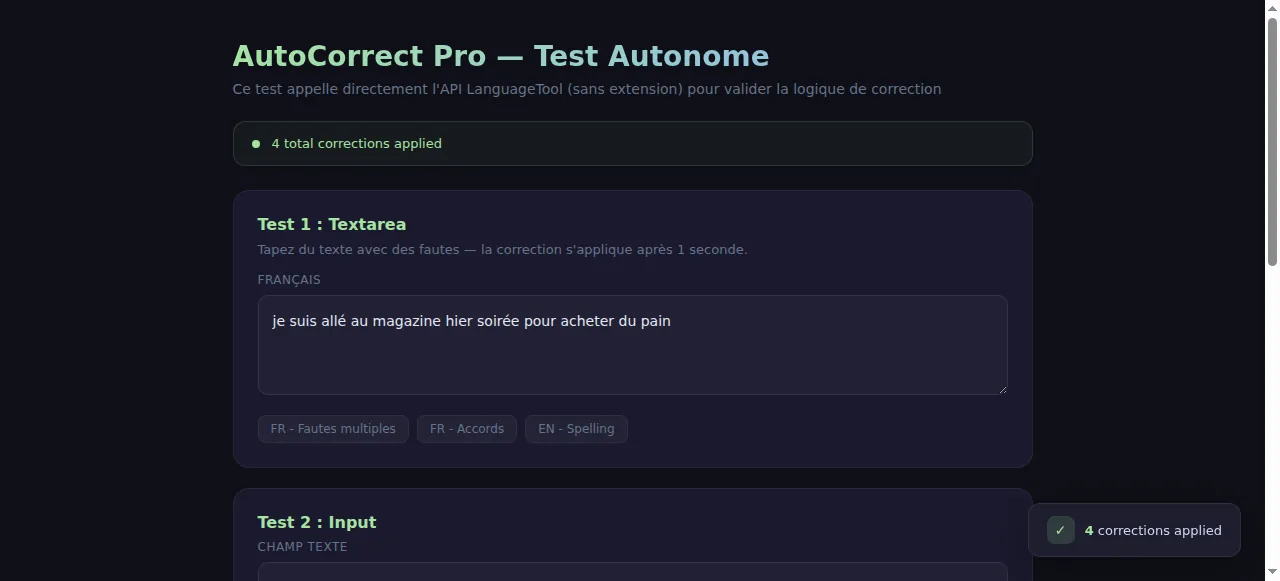
Un moteur de correction intelligent en extension Chrome — pas un simple dictionnaire, un système qui pèse la confiance de chaque correction avant de l'appliquer.
Comment ça est né
AutoCorrect Pro, c'est la correction d'orthographe et de style, mais traitée comme un vrai système plutôt que comme une liste de mots. Le problème de départ : les correcteurs soit cassent le texte, soit ratent de l'appliquer, soit appellent un service à chaque frappe. L'idée : une correction qui pèse la confiance de chaque proposition, et un moteur qui ne s'use jamais.
C'est un projet de robustesse : chaque pièce (cache, backoff, throttle, chunking, chevauchements) existe pour un cas concret qui casserait autrement l'expérience. Le genre d'outil qu'on juge à ce qu'il ne fait pas — pas de correction hasardeuse, pas de service qui s'effondre.
Le contexte
Chaque correction proposée est pondérée par une confiance, et c'est la confiance qui décide d'appliquer ou non : au-dessus du seuil, on applique ; en dessous, on laisse. C'est ce qui évite le correcteur qui « corrige » mal et rend le texte pire qu'avant.
Le moteur fait un checking incrémental : il ne re-coiffe pas tout le texte à chaque frappe, il regarde ce qui a changé. Les résultats passent par un cache LRU, et quand un site fait des erreurs, un backoff exponentiel plus un throttling FIFO lissent l'appel au service — la file des requêtes se vide progressivement, jamais en rafale.
Il gère les longs textes par chunking, résout les chevauchements de corrections (deux corrections qui se marchent dessus sont arbitrées proprement), propose un niveau « picky » conditionnel pour les passages critiques, et tient des statistiques journalières pour savoir ce qui est corrigé le plus.
Ce qui distingue AutoCorrect Pro, c'est le système complet autour du moteur de correction : confiance, cache, backoff, throttle, chunking, chevauchements. Chaque pièce est là pour un cas de robustesse, et le tout est pensé pour ne jamais casser ni ne jamais casser le service.
Le point dur
Corriger sans jamais « décorriger » ni noyer le service
Le point dur, c'est la confiance : appliquer une correction fausse, c'est pire que n'en pas appliquer. J'ai dû calibrer le score de confiance et le seuil pour que le taux de fausses applications reste faible, sans pour autant que le correcteur ne corrige plus rien. C'est un équilibre qui se mesure sur du vrai texte, pas sur un cas idéal.
Le deuxième point dur, c'est la protection du service : un utilisateur qui frappe vite sur un site qui fait des erreurs, c'est des dizaines d'appels par seconde. J'ai dû construire un ensemble de protections — cache LRU, backoff exponentiel, throttle FIFO — qui lissent tout ça sans que l'utilisateur sente un retard. C'est de l'ingénierie de fiabilité, pas de la linguistique.
Fonctionnalités
On ne re-vérifie que ce qui bouge, et on protège le service par cache LRU et backoff exponentiel.
Les requêtes s'empilent dans une file et se lissent pour ne jamais submerger le moteur.
Les gros textes sont découpés en chunks, et les corrections qui se chevauchent sont résolues proprement.
Un mode strict activable sur les passages critiques, au-dessus du seuil habituel.
Un suivi quotidien de ce qui est corrigé le plus, pour calibrer le seuil et le moteur.
Arbitrages techniques
Seuil de confiance plutôt que « tout appliquer »
Ne jamais appliquer une correction hasardeuse ; la qualité prime sur la complétude. Contrepartie : Certaines corrections vraies passent sous le seuil et ne sont pas appliquées.
Checking incrémental
Ne re-vérifier que ce qui bouge ; beaucoup moins d'appels au service. Contrepartie : Il faut un diff fiable pour savoir ce qui a changé ; un texte réorganisé peut forcer un re-check partiel.
Cache LRU + backoff + FIFO
Protéger le service contre les rafales et les erreurs répétées d'un site. Contrepartie : Trois mécanismes à calibrer ensemble ; un mauvais réglage peut introduire du retard perçu.
Chunking des longs textes
Un texte entier est trop gros pour un appel ; on le découpe. Contrepartie : Les chevauchements aux frontières de chunk doivent être résolus, sinon c'est incohérent.
Stack technique
Chromeextension
NLPconfiance + seuil
PerfLRU · backoff exp · FIFO
Robustessechunking · chevauchements
Statsjournalières
En chiffres
confiancescoring + seuil
LRUcache
expbackoff
FIFOthrottle
pickymode strict
Parcours du projet
-
Moteur
Scoring de confiance avec seuil d'application des corrections.
-
Performance
Checking incrémental, cache LRU, backoff exponentiel, throttle FIFO.
-
Robustesse
Chunking des longs textes, résolution des chevauchements.
-
Finitions
Niveau « picky » conditionnel et statistiques journalières.
-
Calibrage
Seuil et moteur ajustés sur du vrai texte, pour un faible taux de fausses applications.
Ce que ça a rendu
-
01
Correction fiable
Pas de fausse correction, pas de texte « décorrige » : la confiance décide.
-
02
Service qui ne casse pas
Cache, backoff et throttle protègent le moteur contre les rafales.
-
03
Un système, pas un dictionnaire
Chaque pièce existe pour un cas de robustesse — l'outil se juge à ce qu'il ne fait pas.