Un fork Vulkan de PrismML, compilé sur GPU AMD, qui fait tourner les gros modèles sans cloud.
LLM local · Inférence · 08/11
Raccoon
Des modèles IA qui tournent en local, sans cloud : j'ai monté et affiné une stack d'inférence complète — contexte jusqu'à 60 000 tokens, vision, cache quantisé, et réveil automatique au message.
Comment ça est né
Raccoon, c'est la machine qui fait tourner des modèles de langage en local, sans dépendre d'un cloud. L'idée : la puissance d'un gros modèle, mais chez soi, sur du matériel que j'ai choisi. Pas de compromis de vie privée, pas de limite de quota, pas de latence de réseau — et une machine qui ne s'allume que quand j'en ai besoin.
Le projet est autant de l'inférence que du tuning : construire une stack qui tient les contextes longs, mesurer systématiquement ce qui marche, et choisir un profil de production. C'est du travail de laboratoire, pas juste de l'installation.
Le contexte
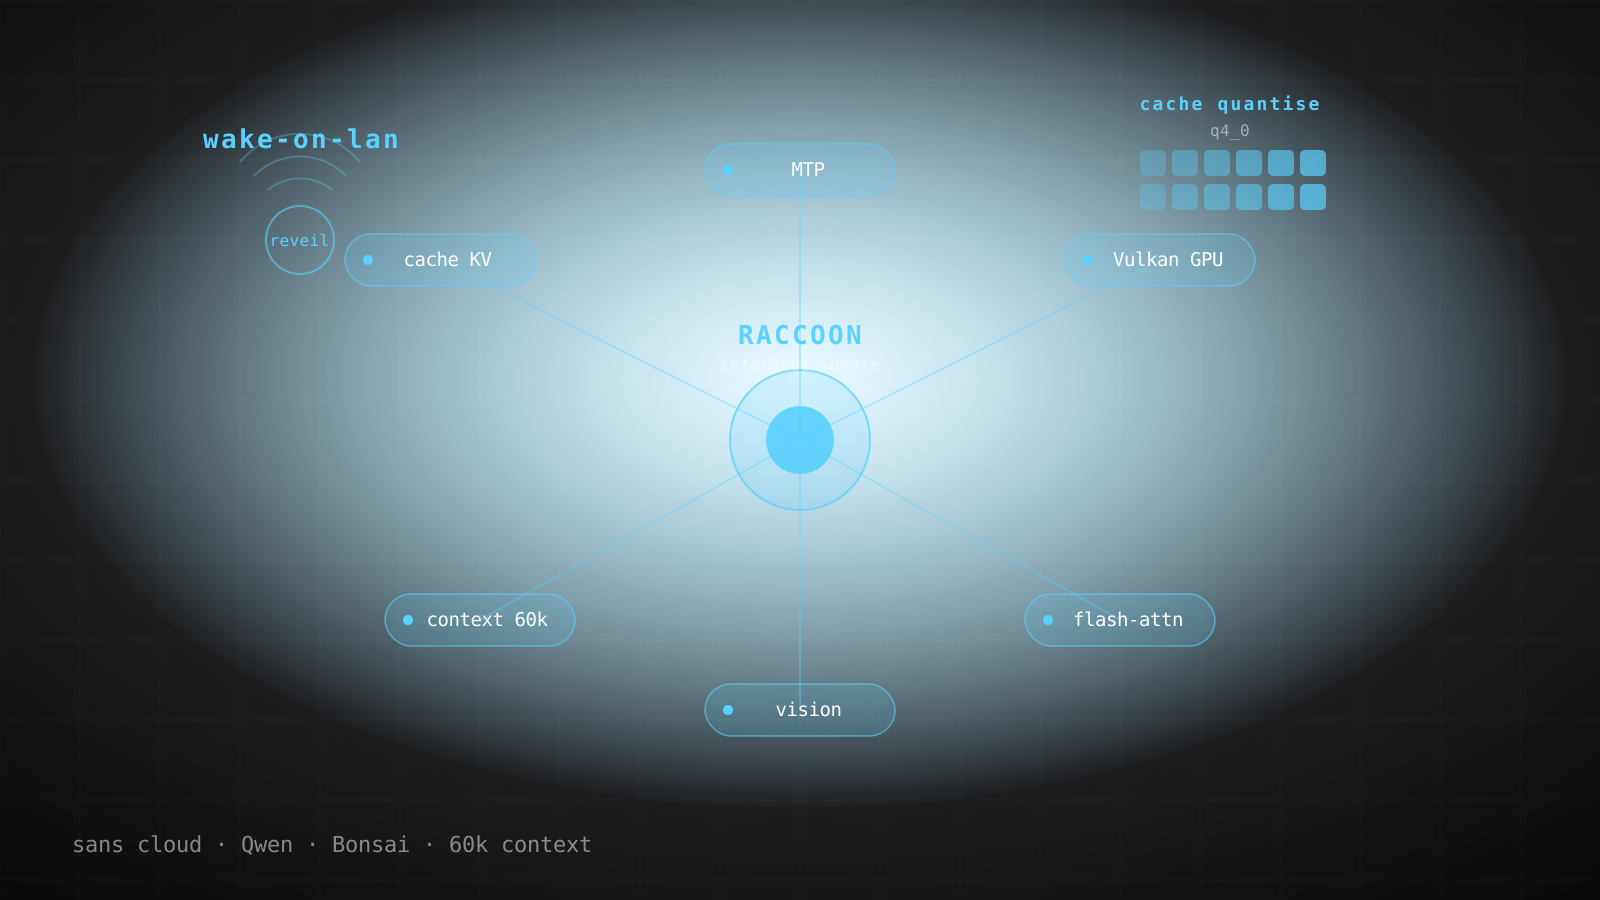
La stack, c'est llama-server branché sur un fork Vulkan de PrismML, compilé sur du GPU AMD. C'est ce branchement qui permet de mettre en mémoire des contextes longs — 55 000, 60 000 tokens — et de quantiser le cache KV pour que ça tienne. La vision est supportée, et flash-attn + MTP (multi-token prediction) améliorent la génération.
Le deuxième pilier, c'est le wake-on-LAN : la machine est éteinte la plupart du temps, et elle s'allume automatiquement dès qu'on lui envoie un message. Pas besoin qu'elle soit éveillée en permanence — c'est l'économie d'énergie et la discrétion qui rendent l'inférence locale réellement tenable au quotidien.
Le reste, c'est de l'ajustement : des presets de contexte, le routage de plusieurs modèles (Qwen, Bonsai) selon les besoins, et la persistance des options par salle de chat — chaque salle garde ses réglages. Et beaucoup de benchmarking : préfill, génération, cache de préfixe, MTP, et une matrice de mesures (KV q4/q5/q8, contextes, MTP n=2/3, Vulkan vs ROCm) pour choisir le profil de production.
Ce qui distingue Raccoon d'un simple « ollama installé », c'est la profondeur du tuning : les contextes longs, la quantification du cache, le MTP, et les mesures systématiques. On ne se contente pas de faire tourner un modèle, on fait tourner le bon modèle, au bon profil, sur le bon matériel.
Le point dur
Faire tenir 60 000 tokens de contexte sur du matériel local
Un contexte de 60 000 tokens, c'est énorme en mémoire : le cache KV, qui stocke l'attention, gonfle avec la taille du contexte. Le point dur, c'est de le faire tenir sans tout quantiser à fond (ce qui dégrade la qualité). J'ai joué sur la quantification du cache KV (q4_0), flash-attn qui réduit le trafic mémoire, et le choix du bon ratio entre mémoire allouée au modèle et mémoire disponible pour le cache. C'est un arbitrage constant.
Le deuxième point dur, c'est le MTP (multi-token prediction) : générer plusieurs tokens par pas, ça accélère, mais l'acceptation doit être suffisante, sinon on n'avance pas vraiment. J'ai mesuré 71,7 % d'acceptation — le seuil au-dessus duquel le MTP est vraiment rentable. C'est ce chiffre, mesuré, qui a décidé de l'activer en production.
Fonctionnalités
Des presets de contexte jusqu'à 60 000 tokens, avec cache KV quantisé (q4_0) pour tenir en mémoire.
La machine s'allume dès qu'un message arrive ; pas besoin qu'elle soit éveillée en permanence.
Plusieurs modèles routés selon les besoins, avec persistance des options par salle de chat.
Multi-token prediction et flash-attn mesurés, et activés au profil de production au-dessus du seuil rentable.
Matrice de mesures systématiques (KV, contextes, MTP, Vulkan vs ROCm) pour arbitrer les profils.
Arbitrages techniques
Vulkan plutôt que ROCm
Stable sur le GPU AMD choisi, et le fork PrismML est branché dessus. Contrepartie : Moins mûr que ROCm pour certains kernels ; il faut valider les performances cas par cas.
Cache KV quantisé (q4_0)
Tient les contextes longs en mémoire sans sacrifier tout le modèle. Contrepartie : Une légère dégradation vs cache plein ; j'ai dû valider que la qualité tient encore.
Wake-on-LAN plutôt que machine allumée
Économie d'énergie et discrétion ; la machine ne vit que quand on en a besoin. Contrepartie : Une latence d'allumage au premier message ; il faut que l'OS et le réseau le supportent.
Routage multi-modèles
Le bon modèle pour la bonne tâche, avec persistance par salle. Contrepartie : Plus de modèles à maintenir et à charger ; un routing à calibrer.
Stack technique
llama-serverfork Vulkan PrismML
GPUAMD · Vulkan
CacheKV q4_0 · flash-attn · MTP
Alimwake-on-LAN au message
ModèlesQwen · Bonsai
En chiffres
60kcontexte
290 t/sprefill
35-40 t/sgénération
71,7 %acceptation MTP
0modèles routés
Parcours du projet
-
Stack
llama-server + fork Vulkan PrismML, compilation sur GPU AMD.
-
Contexte long
Presets 55k/60k, cache KV quantisé, flash-attn, MTP.
-
Benchmarks
Matrice de mesures : KV q4/q5/q8, contextes, MTP n=2/3, Vulkan vs ROCm.
-
Production
Profil de production choisi (MTP au-dessus du seuil), wake-on-LAN, routage multi-modèles.
-
Persistance
Options persistées par salle de chat, modèles routés.
Ce que ça a rendu
-
01
Gros modèles chez soi
La puissance d'un gros modèle, en local, sur du matériel choisi — sans cloud.
-
02
Contextes longs tenus
60 000 tokens, quantifiés et mesurés, sans tout sacrifier à la qualité.
-
03
Économie & discrétion
La machine ne vit que quand on en a besoin, grâce au wake-on-LAN.